
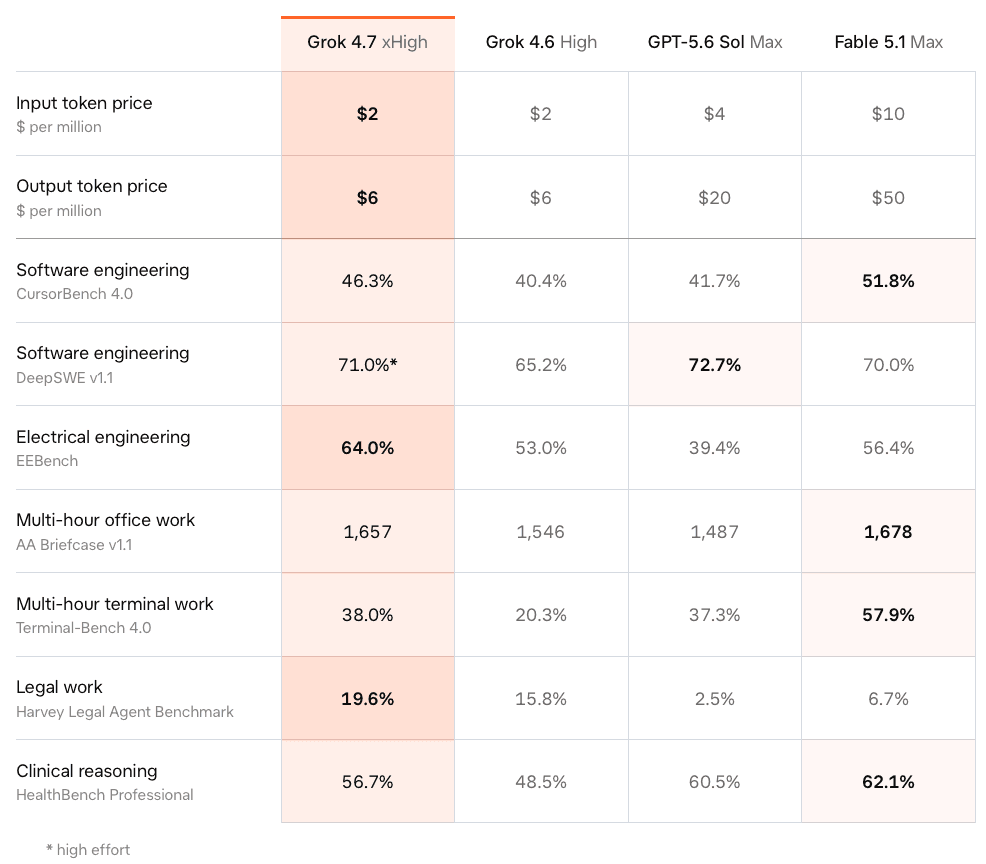
пише Unite.AI.У прес-релізі навели результати роботи моделі ШІ в кількох популярних бенчмарках. У CursorBench v4.0 Grok 4.7 показала кращі результати, ніж GPT-5.6 Sol, але трохи гірші, ніж Fable 5.1 Max. У тесті HackerBench v0.3 нейромережа пропустила лише 3,3% потенційно небезпечних запитів.
Повідомляється, що нова модель від SpaceXAI частіше перевіряє якість власної роботи та працює з довгим контекстом. Також Grok 4.7 стала кращою у завданнях, пов’язаних з офісною роботою, юридичним аналізом та інженерією.
У компанії окремо звернули увагу на нову систему захисних механізмів. Grok 4.7, як зазначається в прес-релізі, стала краще розпізнавати небезпечні запити та протистояти спробам обійти обмеження. У тесті HackerBench v0.3, який оцінює роботу з потенційно небезпечними кіберзавданнями, компанія заявляє про пропуск лише 3,3% ризикованих запитів
При цьому головна перевага Grok 4.7 полягає в ціні: $2 за млн вхідних токенів та $6 за млн вихідних токенів, що значно нижче, ніж у конкурентів. Grok 4.7 вже доступна через Grok API, Cursor і Grok Build.
УНІАН розповідав що помилка ШІ ледь не призвела до війни між США та Китаєм навесні 2026 року. Аналітик Пентагону надто довірився висновкам нейромережі під час аналізу даних.
Вас також можуть зацікавити такі новини:
- "Ми граємо з людськими життями": дослідник Anthropic звільнився через страх перед ШІ
- У Anthropic та OpenAI забили на сполох через ШІ, але це може врятувати людство, – BI
- Глава Nvidia оцінив ймовірність загибелі людства через ШІ до 2030 року
