

Дослідники з компанії Cisco перевірили здатність ШІ-моделей DeepSeek протидіяти спробам користувачів залучити їх до будь-яких зловмисних дій, і результати були тривожними.
Фахівці Cisco використовували алгоритмічні методи джейлбрейка, щоб протестувати передову модель DeepSeek R1. Вони взяли 50 випадкових шкідливих запити з набору HarmBench, щоб перевірити здатність моделі реагувати на шкідливу поведінку (кіберзлочинність, дезінформація, незаконну діяльність тощо).
«Результати були тривожними: DeepSeek R1 продемонстрував 100% успішність атак, тобто він не зміг заблокувати жодного шкідливого запиту. Це різко контрастує з іншими провідними моделями, які продемонстрували принаймні частковий опір», — кажуть в Cisco.
Представники компанії раніше провели аналогічні тести для інших моделей штучного інтелекту. Моделі конкурентів не були досконалими у відбитті таких атак, але все ж мали не такий ганебний результат. Meta Llama 3.1 зазнавала невдач у 96% випадків, тоді як модель OpenAI o1 — лише приблизно в одній чверті випадків.
Дослідники Cisco наголошують, що проблеми з безпекою DeepSeek зумовлені невисокою вартістю розробки моделі. За твердженнями DeepSeek, вона витратила на ШІ лише 6 мільйонів доларів. Тоді як за оцінками шестимісячне навчання GPT-5 OpenAI, який ще не випущено, може коштувати приблизно пів мільярда доларів, і ці витрати охоплюють лише обчислення.
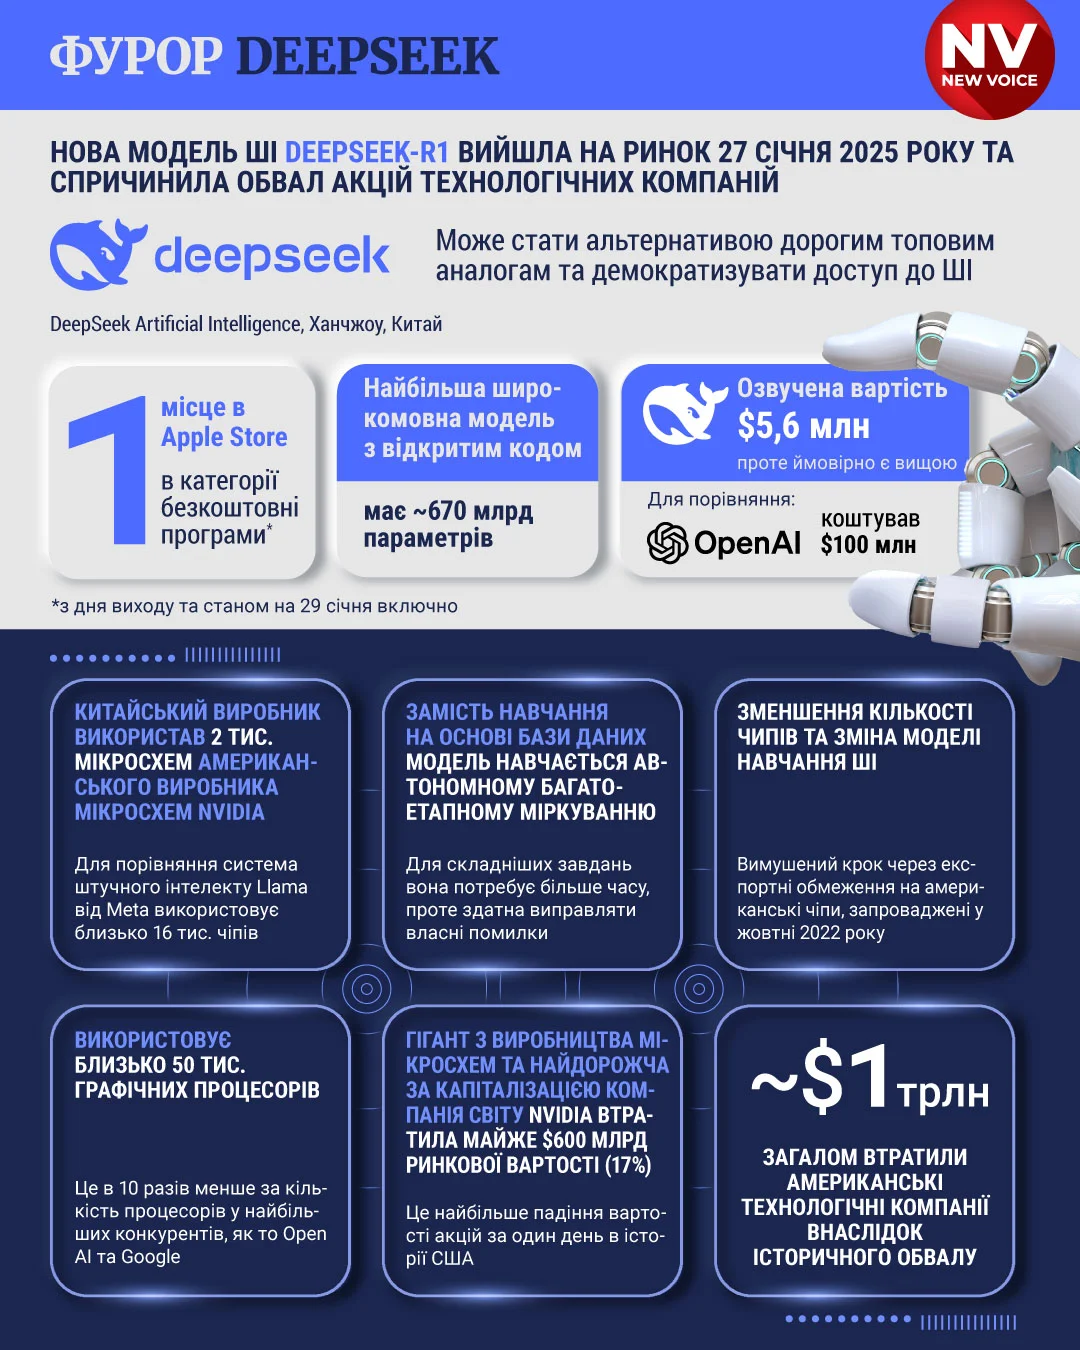
NV Техно раніше писав, щодані багатьох користувачів DeepSeek потрапили у відкритий доступ. Випадковий злив містив і конфіденційні дані.
Читайте також:
- DeepSeek: усе, що потрібно знати про китайський ШІ, який обвалив акції Nvidia і загрожує лідерству ChatGPT
- DeepSeek — це прорив чи шарлатанство?
- Питання якості. Цукерберг порівняв свій ШІ зі значно дешевшими моделями від DeepSeek
